
Case study SEO Truyenhay24h: Kiến trúc, UX và crawl
Giới thiệu dự án
Truyenhay24h.net là dự án tối ưu SEO kỹ thuật và trải nghiệm đọc cho một website truyện tranh có hàng nghìn trang truyện, nhiều chương và lượng ảnh lớn. WebsiteHCM.com tập trung vào ba việc: xác định đúng URL cần xếp hạng, kiểm soát các URL phát sinh từ chương/bộ lọc/tham số và giảm tải cho trang đọc trên thiết bị di động.
Kết quả lưu trong hồ sơ dự án gồm ảnh PageSpeed, Google Search Console và báo cáo traffic. Một số mốc có thể đọc trực tiếp là 23.200 trang hợp lệ và 83.000 lượt nhấp trong khoảng báo cáo được mô tả là ba tháng. Case study này phân biệt rõ số liệu quan sát được với phần chưa đủ dữ liệu để kết luận quan hệ nhân quả.
Bài toán của website truyện tranh quy mô lớn
Mỗi truyện có trang giới thiệu, nhiều trang chương, ảnh đọc truyện, danh sách thể loại và phân trang. Các tham số như ?api=, prev_api hoặc next_api còn có thể tạo nhiều địa chỉ cho cùng nội dung.
Điều này tạo ra bốn rủi ro chính:
- Google khó xác định phiên bản đại diện khi nhiều URL có nội dung giống hoặc rất gần nhau.
- Bot dành thời gian cho URL tham số, bộ lọc hoặc trang mỏng thay vì truyện và chương mới.
- Trang đọc tải nhiều ảnh ngay từ đầu, làm chậm thời điểm người dùng có thể bắt đầu đọc.
- Metadata và dữ liệu lấy từ API không ổn định có thể làm title, ảnh hoặc nội dung thay đổi giữa các lượt tải.
Mục tiêu không phải “index càng nhiều càng tốt”, mà là ưu tiên URL có giá trị và kiểm soát URL không phục vụ nhu cầu tìm kiếm.
Phạm vi WebsiteHCM.com đã triển khai
1. Phân vai Hub – Detail – Reader
Kiến trúc được chia thành ba lớp. Hub tập hợp truyện mới, truyện nổi bật và lối vào các thể loại. Detail là trang chính của từng truyện, chứa tên truyện, mô tả, tác giả, trạng thái, thể loại và danh sách chương. Reader phục vụ nhiệm vụ đọc một chương cụ thể.
Không có quy tắc “mọi trang chương đều phải noindex”. Việc index hoặc đặt canonical phải dựa vào nội dung riêng và nhu cầu tìm kiếm. Google xem canonical là tín hiệu chọn URL đại diện, không phải mệnh lệnh tuyệt đối; xem tài liệu canonicalization của Google.
2. Chuẩn hóa URL và xử lý biến thể cũ
Các URL chương được đưa về cấu trúc dễ đọc, chẳng hạn /truyen/{slug}/chap-{n}/. URL cũ hoặc URL tham số có phiên bản thay thế tương ứng được chuyển hướng 301; trang đích dùng canonical tự tham chiếu khi phù hợp. Việc thay địa chỉ trên thanh trình duyệt bằng JavaScript chỉ cải thiện hiển thị, không thay thế redirect ở phía máy chủ.
Đối với bộ lọc và phân trang, nhóm triển khai xác định mẫu nào có giá trị tìm kiếm thực sự, mẫu nào chỉ phục vụ thao tác tạm thời. Google cảnh báo điều hướng nhiều bộ lọc có thể tạo không gian URL gần như vô hạn và làm chậm việc phát hiện trang hữu ích; xem hướng dẫn về quản lý URL faceted navigation. Bài noindex, nofollow và disallow giải thích thêm sự khác nhau giữa kiểm soát index và kiểm soát crawl.
3. Củng cố trang chi tiết truyện
Trang chi tiết được xem là trung tâm thông tin của mỗi truyện. Title và meta description lấy từ trường dữ liệu đã chuẩn hóa để tránh lỗi ký tự; danh sách chương dùng liên kết HTML có thể truy cập; truyện liên quan và thể loại tạo đường đi sang nội dung cùng chủ đề.
ComicSeries và ComicIssue là các kiểu dữ liệu trong Schema.org, nhưng hiện không xuất hiện như một tính năng rich result riêng trong thư viện dữ liệu có cấu trúc mà Google Search công bố. Vì vậy, chúng có thể được dùng để mô tả thực thể khi dữ liệu trên trang khớp, nhưng không nên quảng cáo là cách bảo đảm rich result hoặc thứ hạng. Các loại được Google hỗ trợ cần đối chiếu tại Search Gallery.
4. Tối ưu trang đọc trên mobile
Ảnh chương được tải theo lô để giảm khối lượng tải ban đầu. Trạng thái tải và ảnh thay thế giúp người đọc hiểu hệ thống đang xử lý thay vì gặp một vùng trắng. Điều hướng chương trước/sau sử dụng dữ liệu đã có hoặc cache, hạn chế gọi API lặp lại.
Lazy loading không được áp dụng máy móc cho mọi ảnh. Ảnh đầu tiên mà người dùng cần thấy có thể phải tải sớm hơn; các ảnh nằm sâu bên dưới mới phù hợp để trì hoãn. Kích thước ảnh, thuộc tính width/height, định dạng và máy chủ ảnh cũng cần được xử lý cùng nhau.
5. Cache API và làm ổn định dữ liệu
Danh sách truyện, dữ liệu chi tiết và taxonomy được lưu tạm theo tần suất cập nhật. Cache giảm request tới API, hạn chế timeout và giữ kết quả ổn định hơn khi nhiều người dùng hoặc bot cùng truy cập.
Ngoài cache, luồng ảnh được chuẩn hóa để xử lý URL thiếu giao thức, đường dẫn tương đối và ảnh lỗi. Đây là phần giao nhau giữa SEO kỹ thuật và UX: bot nhận được tài nguyên nhất quán, còn người đọc ít gặp ảnh hỏng hơn.
Kết quả được ghi nhận trong hồ sơ dự án
Các ảnh dưới đây là bằng chứng theo từng thời điểm, không đủ để khẳng định mọi thay đổi đều do riêng dự án tạo ra. PageSpeed là lần đo cụ thể; Search Console phụ thuộc khoảng ngày và bộ lọc.
Hiệu năng trên thiết bị di động


Hiệu năng trên máy tính


Index và lượt nhấp tự nhiên

Mốc quan sát: 23.200 trang hợp lệ trong báo cáo lập chỉ mục. Để đánh giá tốt hay xấu, cần đối chiếu với số truyện/chương thực có giá trị, sitemap và nhóm URL không được index.

Mốc quan sát: 83.000 lượt nhấp tự nhiên trong khoảng báo cáo được mô tả là ba tháng. Đây là tổng lượt nhấp trong kỳ, không phải mức tăng 83.000 lượt và cũng chưa chứng minh phần traffic đó đến từ một thay đổi kỹ thuật riêng lẻ.
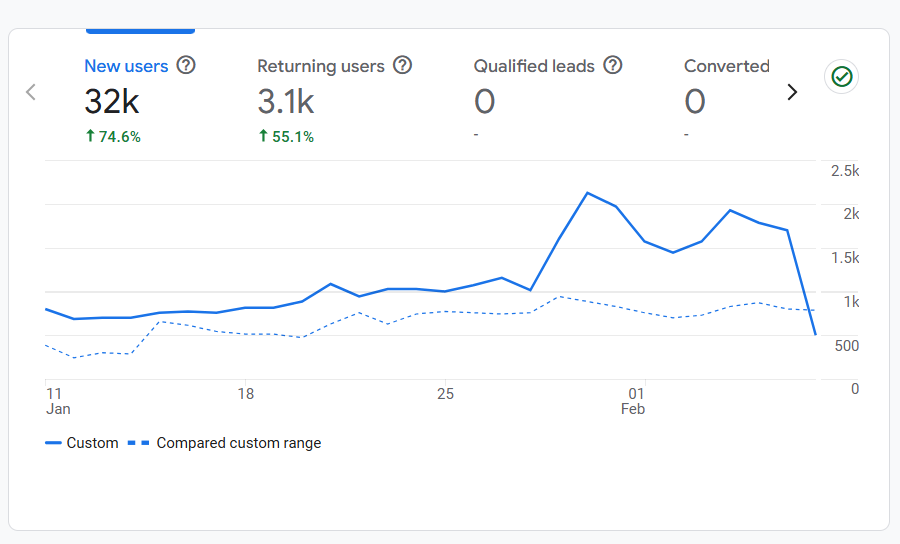
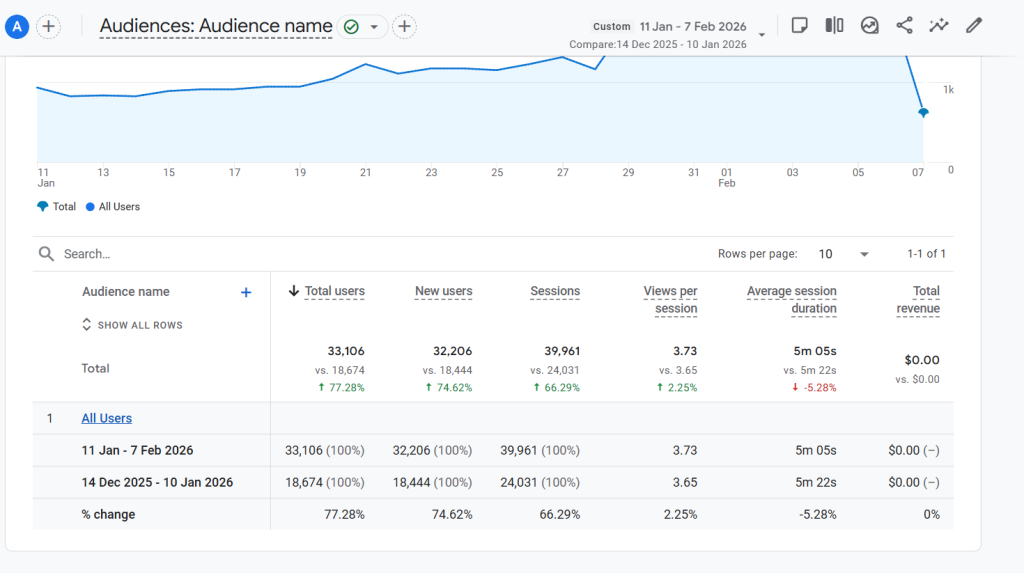
Insight, nguồn traffic và người dùng mới


Giới hạn khi diễn giải kết quả
- Hồ sơ chưa có bảng trước–sau dùng cùng khoảng ngày, cùng thiết bị và cùng bộ lọc cho tất cả chỉ số.
- 23.200 trang hợp lệ là quy mô index tại thời điểm chụp, không đồng nghĩa 23.200 trang đều có traffic hoặc chất lượng ngang nhau.
- 83.000 lượt nhấp là tổng trong kỳ được mô tả, không phải phần tăng thêm có thể quy hoàn toàn cho dự án.
- Insight 71% thiếu tên chỉ số và kỳ so sánh trong phần mô tả công khai, nên cần mở báo cáo gốc trước khi sử dụng trong tài liệu bán hàng.
- Chưa có dữ liệu công khai về đăng ký, doanh thu hoặc giá trị kinh doanh phát sinh từ traffic.
Bài học có thể áp dụng cho website nội dung lớn
- Xác định URL sở hữu intent trước khi sửa canonical. Canonical không thể thay cho quyết định kiến trúc và nội dung.
- Đừng index mọi biến thể hệ thống tạo ra. Bộ lọc, tìm kiếm và phân trang cần được đánh giá theo giá trị thật đối với người tìm kiếm.
- Tối ưu trang đọc phải bắt đầu từ ảnh. Tải theo lô, kích thước ảnh và chiến lược ưu tiên ảnh đầu tiên ảnh hưởng trực tiếp đến trải nghiệm mobile.
- Cache API là biện pháp ổn định, không chỉ tăng tốc. Nó giảm phụ thuộc vào nguồn dữ liệu ở mỗi lượt truy cập.
- Đo trước khi triển khai. Lưu mốc GSC, Analytics, PageSpeed, sitemap và mẫu URL giúp đánh giá sau dự án đáng tin hơn.
Doanh nghiệp đang vận hành website có nhiều nghìn URL có thể dùng thêm checklist nghiệm thu website chuẩn SEO để kiểm tra template, index và dữ liệu đo lường trước khi mở rộng nội dung.
Cần chuẩn bị gì khi yêu cầu audit website tương tự?
Hãy chuẩn bị tên miền, sitemap, các loại template, 10–20 URL mẫu, quyền xem Search Console, báo cáo Analytics, nguồn API và vấn đề đang gặp. WebsiteHCM.com sẽ tách lỗi kiến trúc URL, dữ liệu, index và trải nghiệm trước khi đề xuất phạm vi.
Nếu cần kiểm tra SEO kỹ thuật và cơ hội tăng trưởng, xem dịch vụ SEO của WebsiteHCM.com. Nếu dự án phải sửa cả giao diện, template đọc và luồng dữ liệu, tham khảo dịch vụ thiết kế website theo yêu cầu để xác định phần nên sửa và phần nên giữ.
Công nghệ
WordPress + Flatsome + API + JS Reader
Câu hỏi thường gặp
Dự án này tập trung tối ưu những gì?
Tập trung 3 lớp: SEO nền tảng (cấu trúc + canonical + schema), UX đọc truyện trên mobile (lazy-load, điều hướng) và ổn định kỹ thuật (cache API, giảm lỗi ảnh/crawl).
Vì sao website truyện tranh dễ bị trùng lặp nội dung (duplicate content)?
Vì cùng một nội dung có thể sinh nhiều URL khác nhau: query URL, phân trang, lọc, prev/next, và các phiên bản đường dẫn khác nhau. Nếu không kiểm soát canonical/noindex, Google dễ index “lan man” và loãng tín hiệu.
Trang “Detail” và “Reader” khác nhau thế nào?
Detail: trang SEO chính của truyện (gom tín hiệu: title/meta, schema, danh sách chương, internal link).
Reader: trang đọc chương, ưu tiên trải nghiệm đọc mượt và điều hướng nhanh.
Canonical nên trỏ về detail hay giữ ở reader?
Tuỳ chiến lược SEO:
Nếu ưu tiên gom tín hiệu về 1 trang mạnh: thường canonical reader → detail.
Nếu muốn SEO cho từng chương: có thể giữ canonical riêng, nhưng phải kiểm soát index rất chặt để tránh trùng lặp.
Vì sao cần lazy-load ảnh theo lô thay vì lazy-load từng ảnh một lần?
Lazy-load theo lô (ví dụ 3 ảnh/lần) giúp:
Tải nhanh phần đầu (LCP tốt hơn)
Giảm giật lag khi scroll
Dễ kiểm soát bộ nhớ và trải nghiệm đọc liên tục trên mobile
Cache API giúp gì cho SEO?
Cache giúp ổn định tốc độ phản hồi và giảm lỗi timeout khi bot crawl. Website ổn định → Google crawl đều hơn, index ổn định hơn.
Làm sao biết tối ưu có hiệu quả thật?
Đối chiếu bằng:
Google Search Console: clicks, impressions, CTR, index/coverage, duplicate/alternate canonical
GA4: engagement time, pages/session, user mới
PageSpeed Insights: LCP/CLS/INP và điểm mobile
Thời gian thấy kết quả SEO thường là bao lâu?
Tối ưu kỹ thuật thường thấy tín hiệu trong 2–6 tuần (index/crawl ổn định hơn). Tăng trưởng traffic mạnh hơn thường cần 6–12 tuần tuỳ cạnh tranh và mức độ mở rộng nội dung.
Dự án này phù hợp với website nào?
Phù hợp với website có:
Nhiều trang/ảnh, dữ liệu lớn (truyện, phim, tin, sản phẩm)
Có vấn đề duplicate URL, phân trang sâu, index rác
Cần tối ưu mobile UX và ổn định crawl/index
Cách kiểm chứng số liệu
Bạn có thể đối chiếu theo Google Search Console (hiệu suất tìm kiếm), Google Analytics (traffic & chuyển đổi), PageSpeed Insights (Core Web Vitals) và log triển khai.

Case study SEO local Taxi Long Mỹ: Cấu trúc và UX đặt xe

Case study baogiathepxaydung.com: SEO và UX báo giá

Case study Content Marketing Haivenu: Traffic tăng 70%

Case study website Việt Thiên Thư: Dữ liệu, UX và SEO

Case study website Cơm Niêu Phố Núi: Menu và UX
