

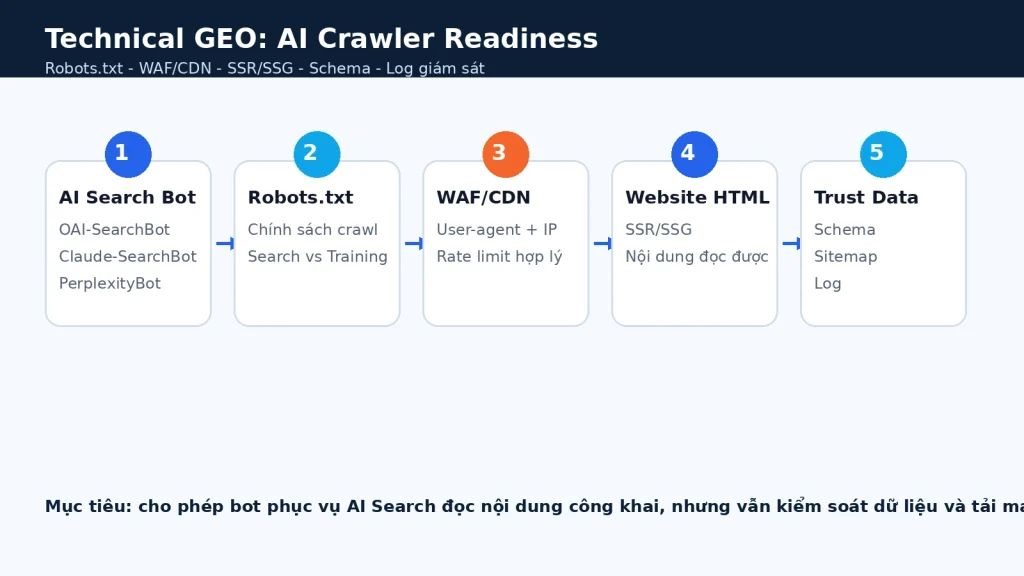
Technical GEO là kiểm tra khả năng truy cập nội dung công khai của Search crawler và hệ thống AI có dùng web. Cần tách ba lớp: chính sách crawler trong robots.txt, khả năng request thực sự đi qua CDN/WAF/server, và nội dung đủ điều kiện được render hoặc lập chỉ mục. Một lớp đạt không chứng minh hai lớp còn lại đã đạt; ngay cả khi đủ điều kiện kỹ thuật, website vẫn không được bảo đảm index, xuất hiện hoặc được AI trích dẫn.
Nếu cần bức tranh tổng thể trước khi đi sâu vào crawler, robots.txt và WAF, xem chiến lược GEO cho SEO và AI Search. Nếu URL đã được tìm thấy nhưng không được chọn làm nguồn, xem framework Eligibility → Retrieval → Selection.
Technical GEO là gì và không phải là gì?
Technical GEO hữu ích khi cần trả lời bốn câu hỏi: nội dung nào được công khai, crawler nào được phép truy cập, lớp hạ tầng nào đang chặn nhầm bot hợp lệ và dữ liệu nào chứng minh việc truy cập thực sự xảy ra.
| Có thể làm | Không bảo đảm |
|---|---|
| Phát hiện robots, WAF, 403/429, redirect và rendering gap. | Được AI trích dẫn hoặc xếp hạng theo một tỷ lệ cố định. |
| Tách search, training và user-triggered access. | Một robots rule đúng cho mọi nền tảng. |
| Tạo evidence từ log, Search Console và referral. | Bot crawl nhiều = nội dung được đánh giá cao. |
| Giảm lỗi crawl/index trên URL quan trọng. | Technical fix thay thế content quality, relevance hoặc authority. |
Crawler: đừng gom mọi “AI bot” thành một nhóm
| Nền tảng / bot | Mục đích | Điểm quản trị |
|---|---|---|
| Googlebot | Crawl cho Google Search. | Kiểm robots, status, render, indexability và canonical. |
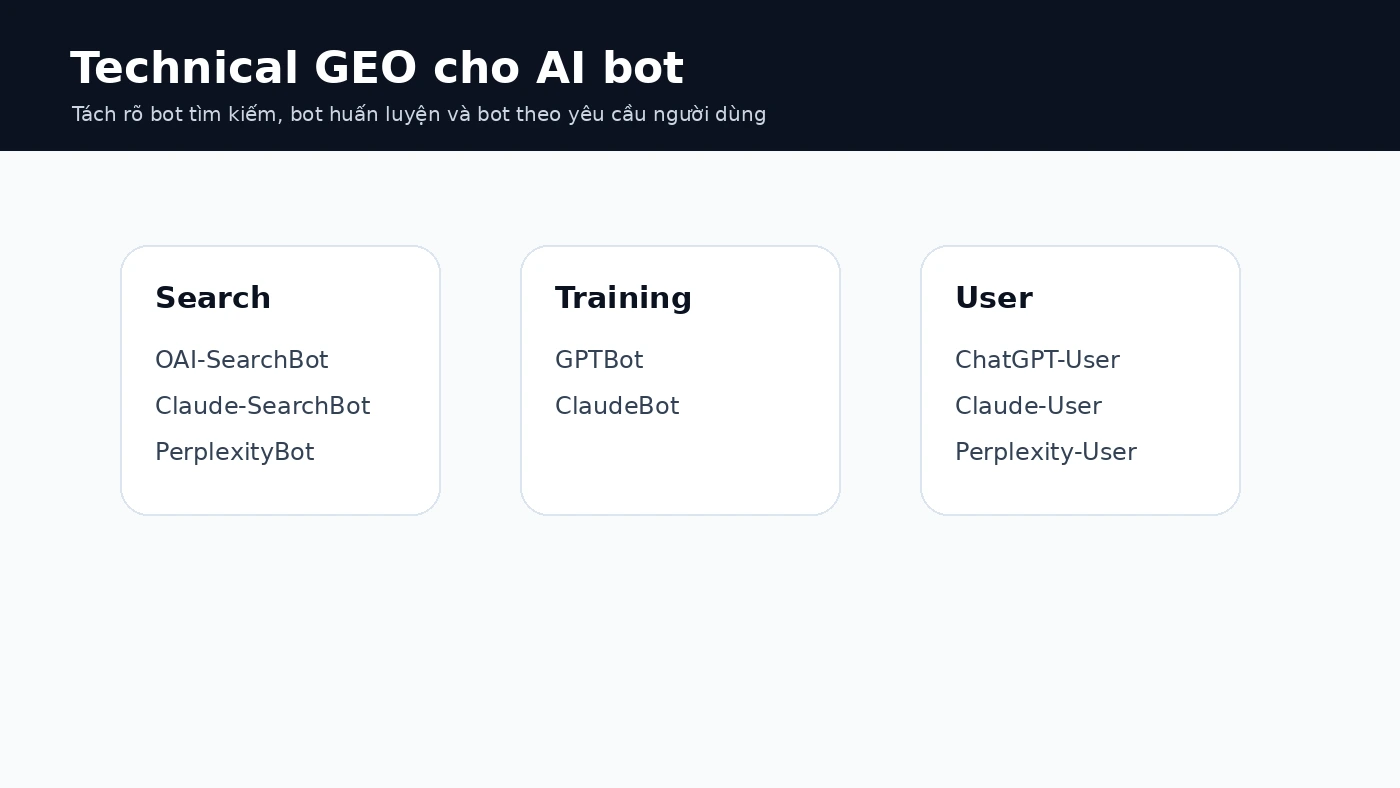
| OAI-SearchBot | Search features của ChatGPT. | Quản trị độc lập với GPTBot. |
| GPTBot | Crawler liên quan tới cải thiện/huấn luyện mô hình OpenAI. | Allow/Disallow theo data policy. |
| ChatGPT-User | User-triggered access. | Không đồng nhất với Search crawler. |
| Claude-SearchBot / ClaudeBot / Claude-User | Search, training và user-triggered access của Anthropic. | Quản trị theo mục đích và tài liệu hiện hành. |
| PerplexityBot / Perplexity-User | Search/index và user-triggered access. | Kiểm policy và IP ranges hiện hành. |
Crawler, IP và policy có thể thay đổi. Theo OpenAI Crawlers, ChatGPT-User là truy cập theo yêu cầu và robots.txt có thể không áp dụng; Perplexity Crawlers nói Perplexity-User thường không tuân robots.txt. Anthropic thông báo từ 30/10/2026 bắt đầu hỗ trợ thêm tín hiệu từ chối AI training và đang triển khai dần; quy tắc chỉ đích danh ClaudeBot được ưu tiên so với tín hiệu chung. Kiểm tra tài liệu từng hãng trước khi đổi chính sách, không coi một quy tắc là áp dụng cho tất cả.
Robots.txt là crawl policy, không phải security control
Robots.txt thể hiện preference truy cập nhưng không bảo vệ dữ liệu nhạy cảm và không phải cơ chế chắc chắn để loại URL khỏi index. Trang account, admin, tài liệu trả phí hoặc dữ liệu khách hàng cần authentication/authorization phù hợp. Nếu cần deindex, dùng chỉ thị phù hợp và bảo đảm crawler có thể đọc chỉ thị đó.
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Đây chỉ là hai nhóm minh họa lựa chọn Search và training của OpenAI, không phải robots.txt đầy đủ cho WordPress. Theo đặc tả xử lý robots.txt của Google, một nhóm User-agent cụ thể không kế thừa quy tắc của nhóm *; chèn bừa Allow: / có thể làm mất hiệu lực hạn chế crawl dự kiến. Trước khi sửa live, xem hướng dẫn robots.txt, kiểm tra đúng host, bot, đường dẫn, phiên bản và phương án hoàn tác. Với admin, đơn hàng hoặc dữ liệu khách, dùng xác thực và phân quyền, không dựa vào robots.txt để bảo vệ.
WAF, CDN và bot verification
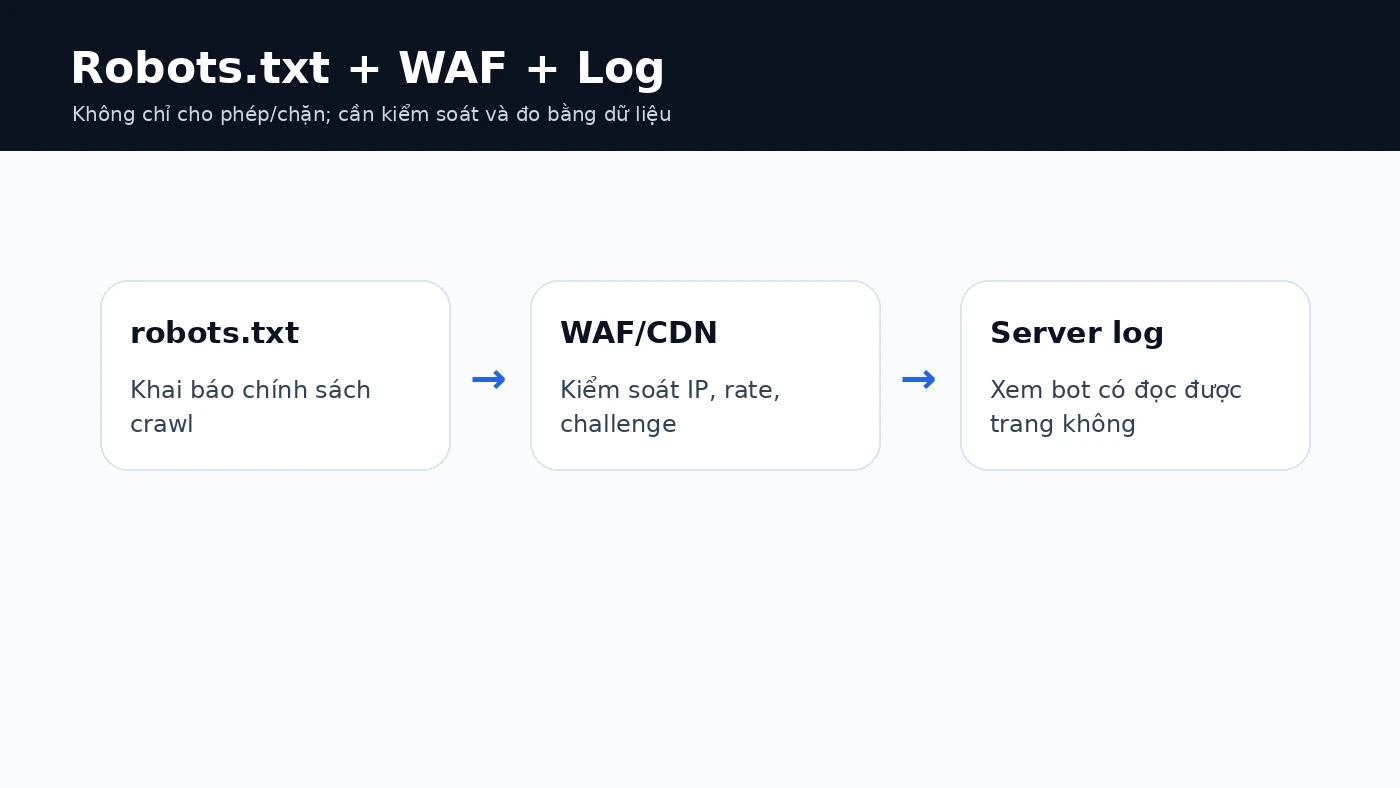
Không allowlist chỉ bằng User-agent: tên bot có thể bị giả. Khi hãng công bố IP range hoặc phương pháp xác minh, hãy đối chiếu request thật với dữ liệu chính thức, WAF/CDN edge log và log origin nếu có. Chỉ thử ngoại lệ trên URL công khai và bot đã xác minh; giữ nguyên bảo vệ đăng nhập, thanh toán, API nhạy cảm. Sau thay đổi, ghi rule ID, thời điểm, HTTP 403/429/challenge trước–sau, người phê duyệt và phương án rollback. Việc nhận HTTP 200 không chứng minh crawler đã index hay dẫn nguồn.
| Finding | Evidence | Fix |
|---|---|---|
| 403/401 | WAF event, rule ID, URL, UA/IP. | Xác minh bot và sửa rule có phạm vi. |
| 429 | Rate-limit logs và cadence. | Điều chỉnh quota theo capacity. |
| UA đúng, IP không khớp | Published ranges/verification method. | Không mặc định là bot chính thức. |
| Challenge page | Response HTML hoặc WAF log. | Loại challenge cho bot đã xác minh nếu policy cho phép. |
Rendering: kiểm raw HTML và rendered output
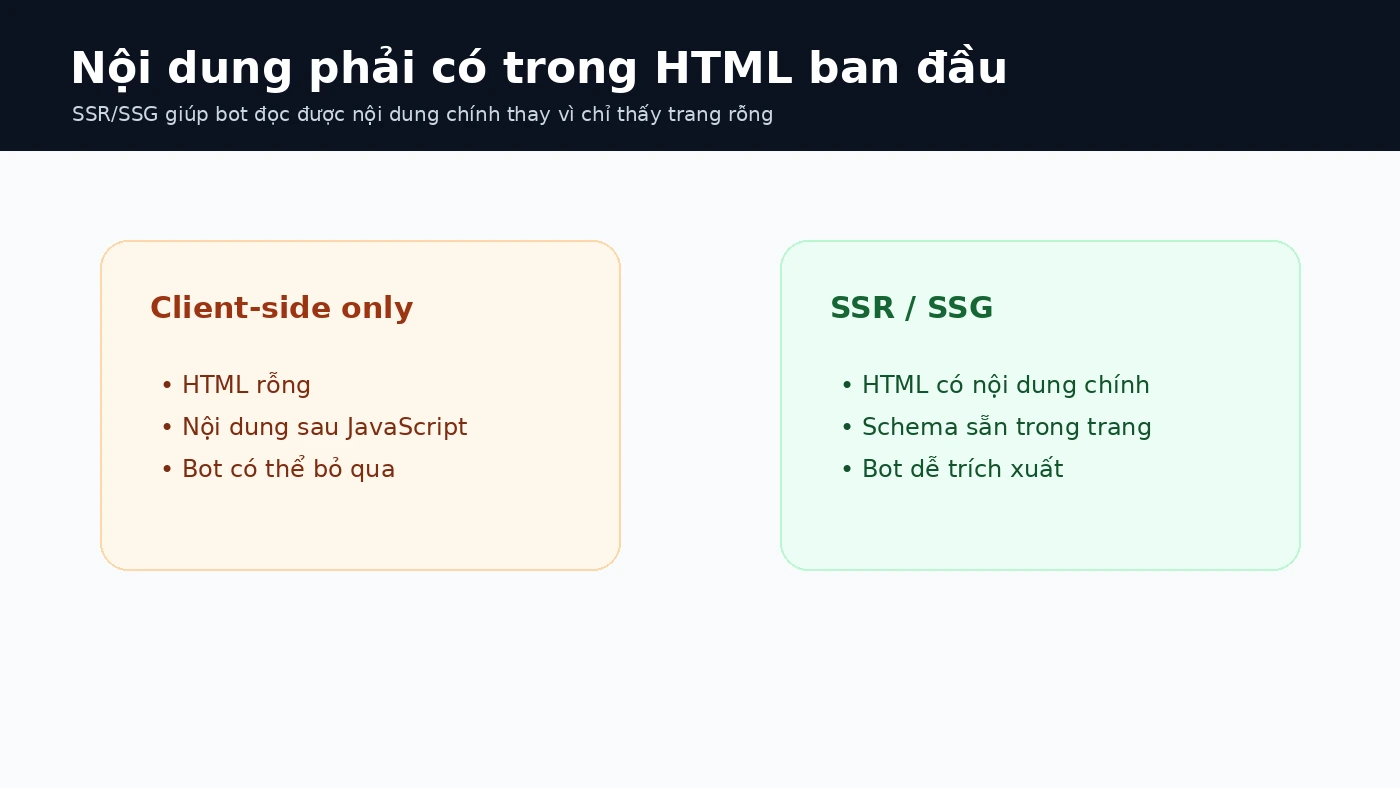
Googlebot có thể render JavaScript, nhưng một số crawler khác không có cùng năng lực hoặc thời điểm render. Với URL quan trọng, hãy so HTML trả về ban đầu, bản render, nội dung chính, canonical, liên kết và structured data; ghi rõ bot và công cụ dùng để kiểm tra, thay vì kết luận “AI chỉ đọc HTML ban đầu”. Nếu phụ thuộc client-side JavaScript khiến nội dung hoặc link không xuất hiện ổn định, cân nhắc SSR/SSG và đối chiếu hướng dẫn Technical SEO trước khi thay kiến trúc.
Structured data và llms.txt
Không có “AI schema”. Structured data phải khớp nội dung hiển thị và chỉ tạo eligibility cho các Search features được hỗ trợ; validation PASS không bảo đảm rich result. Với Google Search, llms.txt không phải requirement và không nên được coi là sitemap, robots directive hoặc ranking signal.
Server log đo access, không chứng minh citation
Log chỉ chứng minh một request đã được ghi tại lớp đang đo. Bot bị WAF chặn có thể chỉ xuất hiện ở edge log mà không tới origin; User-agent tự khai báo chưa đủ xác minh danh tính bot. Khi điều tra, nối thời điểm, URL, UA/IP đã xác minh, HTTP status, WAF rule và kích thước phản hồi; lưu bằng chứng trước/sau với quyền truy cập và thời hạn lưu phù hợp, tránh ghi token hay dữ liệu khách. Crawl thành công không chứng minh index, training, AI citation hay doanh thu.
Đo hiệu quả sau triển khai
| Lớp đo | Nguồn | Giới hạn |
|---|---|---|
| Access | Server/WAF logs, robots và HTTP response. | Access không bảo đảm index/citation. |
| Google Search | URL Inspection, Search Console Performance và báo cáo Generative AI của Google nếu có. | Báo cáo AI ghi impressions theo URL/ngày/thiết bị/quốc gia; không tự cho biết click, lead hoặc vì sao AI chọn nguồn. Không cộng trùng với số liệu Performance Web. |
| AI referral | Analytics/referrer khi có. | Không đo mention/citation không tạo click. |
| Business outcome | Lead, booking, purchase, CRM. | Cần attribution và deduplication. |
Checklist Technical GEO theo decision gate
- Policy: search, training và user-triggered access có quyết định riêng.
- Robots: rule đúng host/subdomain và user-agent hiện hành.
- WAF/CDN: bot hợp lệ không bị 403/429/challenge ngoài chủ đích.
- Render: primary content, links, metadata và schema xuất hiện trong rendered output.
- Indexability và Google AI: kiểm status, canonical, robots meta, sitemap và internal link; với Google Search kiểm thêm Settings → Search generative AI (Include/Exclude/Inherit từ 31/08/2026). Đây là quyền tham gia AI Search của Google, không phải chỉ thị training, không bảo đảm được AI chọn và không áp dụng mặc nhiên cho ChatGPT hay Claude.
- Logs: có timestamp, URL, status, UA/IP và retention phù hợp.
- Measurement: Search Console, referral và business outcome có baseline.
Nguồn cần đối chiếu
- Google Search Central — AI features and your website
- Google — Optimizing for generative AI features
- OpenAI Crawlers
- Anthropic crawler guidance
- Perplexity Crawlers
Kết luận
Technical GEO là quản trị crawler, Technical SEO, bảo vệ truy cập và đo lường có chứng cứ. Hãy bắt đầu bằng một URL quan trọng, một nhóm bot theo mục đích, log của lớp đang chặn và phép thử trước/sau; chỉ triển khai rule khi có người chịu trách nhiệm và cách hoàn tác. Nếu trang đã đáp ứng điều kiện kỹ thuật mà vẫn chưa được dẫn nguồn, nên xem xét chất lượng và mức liên quan của nội dung thay vì tiếp tục mở WAF. Doanh nghiệp cần rà soát phạm vi triển khai có thể tham khảo dịch vụ tư vấn GEO; chuẩn bị URL, hệ thống CDN/WAF, môi trường thử và quyền log phù hợp, không gửi mật khẩu hoặc dữ liệu cá nhân qua form công khai.

Đoàn Trình Dục là Giảng viên Khoa Công nghệ Thông tin tại Đại học Công nghệ Sài Gòn (STU), với hơn 10 năm kinh nghiệm thực chiến trong các lĩnh vực Mạng máy tính, Marketing Online, SEO và Bảo mật hệ thống.
Với nền tảng sư phạm và kinh nghiệm tư vấn cho nhiều doanh nghiệp, thầy chuyên sâu vào việc xây dựng các giải pháp kỹ thuật số toàn diện và hiệu quả.