


De-indexed là trạng thái một URL từng được Google index nhưng sau đó không còn nằm trong index hoặc không còn được chọn làm URL đại diện để phục vụ trong Search. URL mới ở trạng thái Discovered – currently not indexed hay Crawled – currently not indexed không nên tự động gọi là de-indexed.
Chẩn đoán đúng cần đi theo chuỗi: lịch sử index → URL Inspection → HTTP/robots/noindex → canonical → rendered content → URL ownership/content → internal links/sitemap → Request Indexing sau cùng.
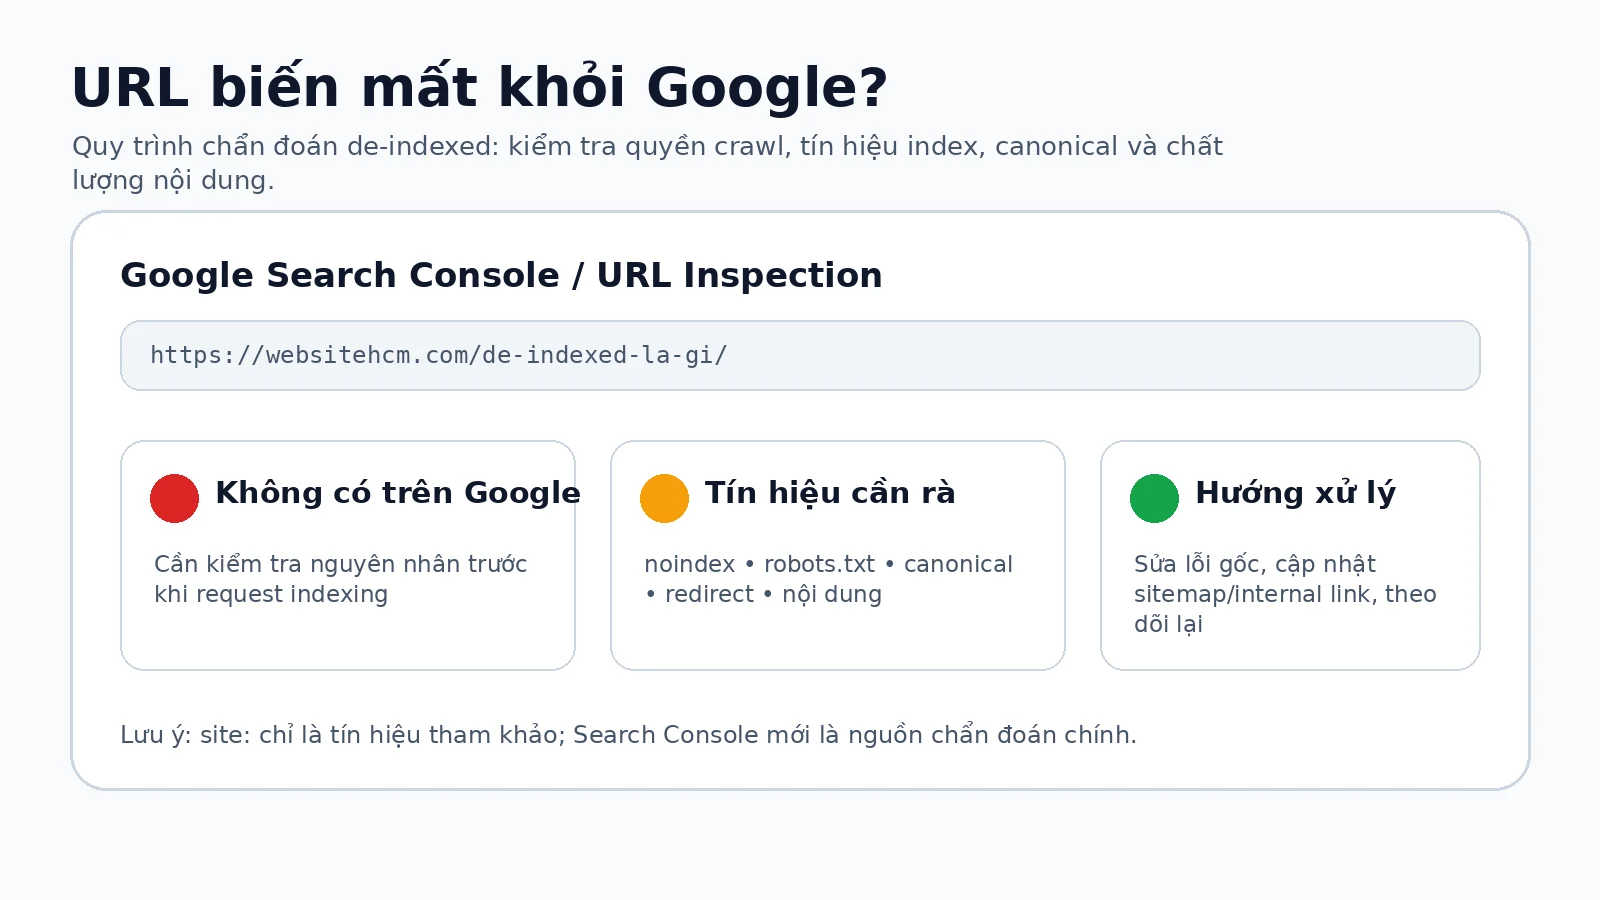
De-indexed khác “not indexed” và tụt hạng thế nào?
| Trạng thái | Bản chất | Evidence ưu tiên |
|---|---|---|
| De-indexed | URL từng index, nay không còn index/được phục vụ. | Lịch sử Performance + URL Inspection. |
| Discovered – currently not indexed | Google biết URL nhưng chưa crawl. | Page Indexing, internal links, sitemap, logs. |
| Crawled – currently not indexed | Google đã crawl nhưng chưa chọn index. | Inspection, canonical, rendered content, duplicate/content ownership. |
| Noindex | Trang yêu cầu không được index. | Meta robots/X-Robots-Tag. |
| Canonical sang URL khác | Google ưu tiên URL đại diện khác. | User-declared và Google-selected canonical. |
| Tụt hạng | URL vẫn index nhưng visibility giảm. | Performance report và SERP. |
Nếu cần nền tảng về quá trình index, xem Google Index là gì.
Dấu hiệu nào đủ mạnh để nghi URL bị de-indexed?
Không nên kết luận từ truy vấn site:. Hãy kết hợp lịch sử impression/click, URL Inspection, Page Indexing, canonical và phản hồi HTTP/rendered page.
| Evidence | Cho biết | Không chứng minh |
|---|---|---|
| URL Inspection | Google đang ghi nhận index/canonical thế nào. | Trạng thái live tuyệt đối nếu dữ liệu chưa cập nhật. |
| Live Test | Google có thể fetch/render lúc test. | URL chắc chắn sẽ được index. |
| Performance theo page | URL từng có impressions/clicks và thời điểm biến động. | Mất impression luôn đồng nghĩa mất index. |
| Page Indexing | Nhóm lý do URL không index. | Inventory real-time hoàn chỉnh. |
| Server/CDN logs | Status, crawl request, lỗi máy chủ. | Request thành công = đã index. |
Phân biệt de-indexed, noindex, canonical và removal
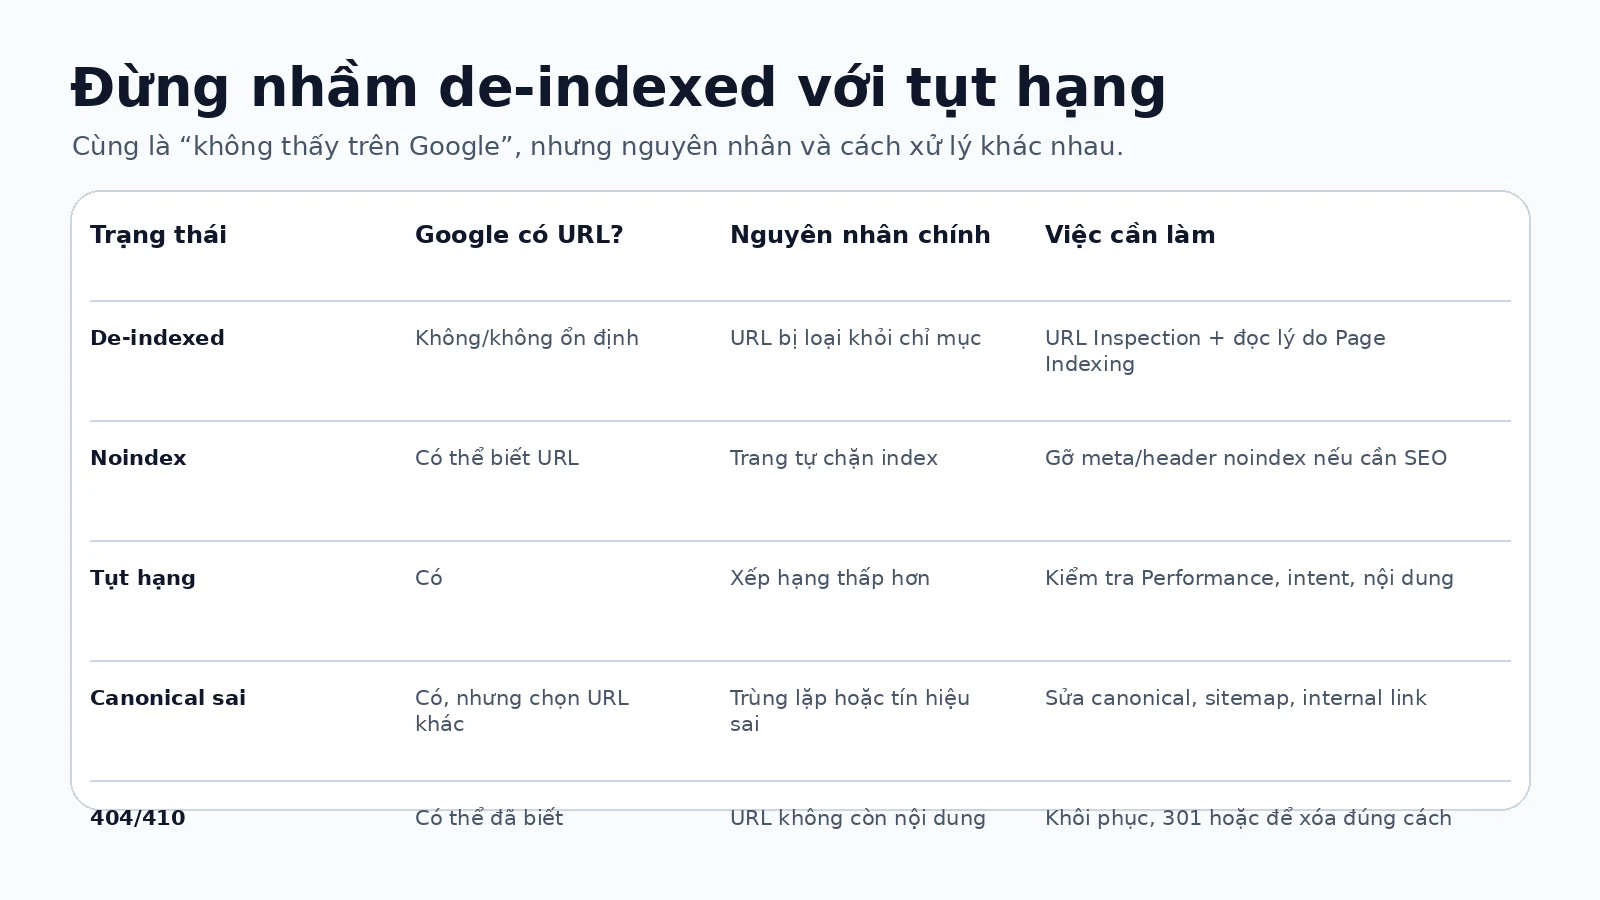
| Tình huống | Điểm cần nhớ | Hướng xử lý |
|---|---|---|
| noindex | Googlebot phải crawl được URL để thấy directive. | Gỡ noindex chỉ khi URL thực sự cần Search. |
| robots.txt block | Robots quản lý crawl, không phải cơ chế noindex. | Mở crawl nếu cần Google đọc nội dung/directive. |
| Canonical khác | Canonical là tín hiệu, không phải lệnh bắt buộc. | Đồng bộ content, links, sitemap và canonical. |
| Temporary removal | Removals Tool chỉ ẩn tạm. | Dùng noindex/404/410/auth phù hợp cho xử lý lâu dài. |
| 404/410 | Tài nguyên không còn. | Giữ status đúng hoặc redirect khi có bản thay thế tương đương. |
| Manual action | Có báo cáo riêng trong Search Console. | Remediate đầy đủ rồi reconsideration nếu áp dụng. |
| Security issue | Hack/malware/phishing là luồng incident riêng. | Dọn sạch, vá nguyên nhân, xác minh rồi review. |
Crawled và Discovered – currently not indexed
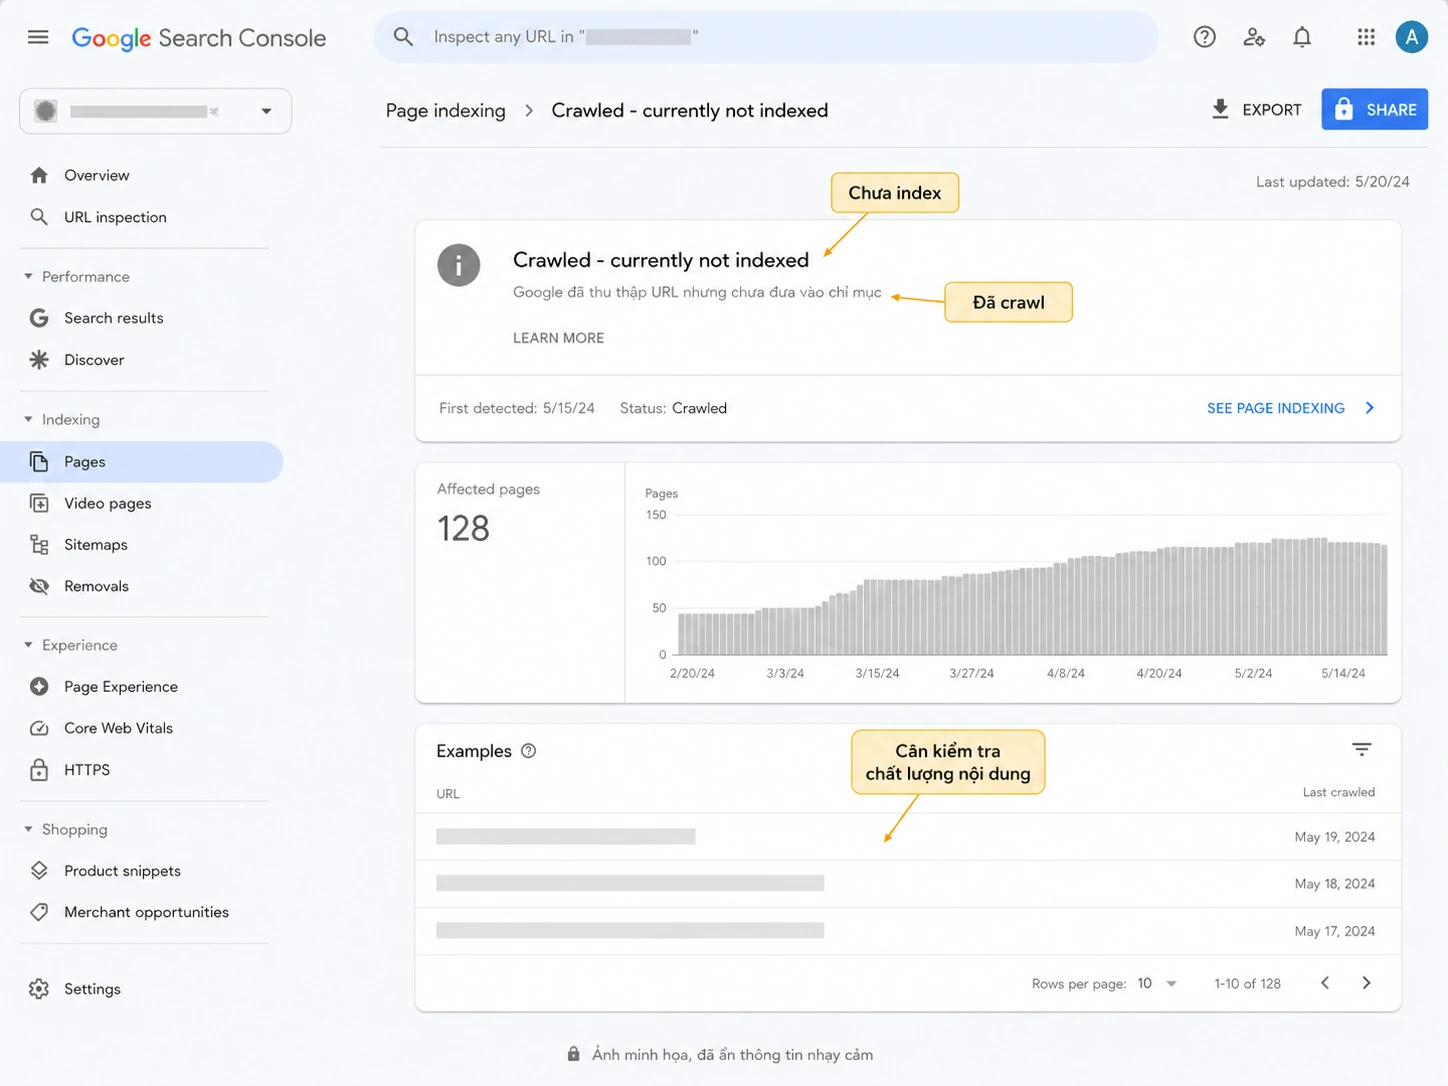
Discovered nghĩa là Google biết URL nhưng chưa crawl; hãy kiểm tra discovery, internal links, sitemap, URL space và server capacity. Crawled nghĩa là Google đã crawl nhưng hiện chưa index; hãy kiểm tra canonical/duplicate, soft 404, rendering, content ownership và usefulness.
Đừng “thêm chữ” hoặc bấm Request Indexing lặp lại như một công thức. Nếu nhiều URL cùng task, có thể vấn đề là phân vai URL chứ không phải thiếu độ dài nội dung.
Quy trình chẩn đoán và phục hồi URL mất index
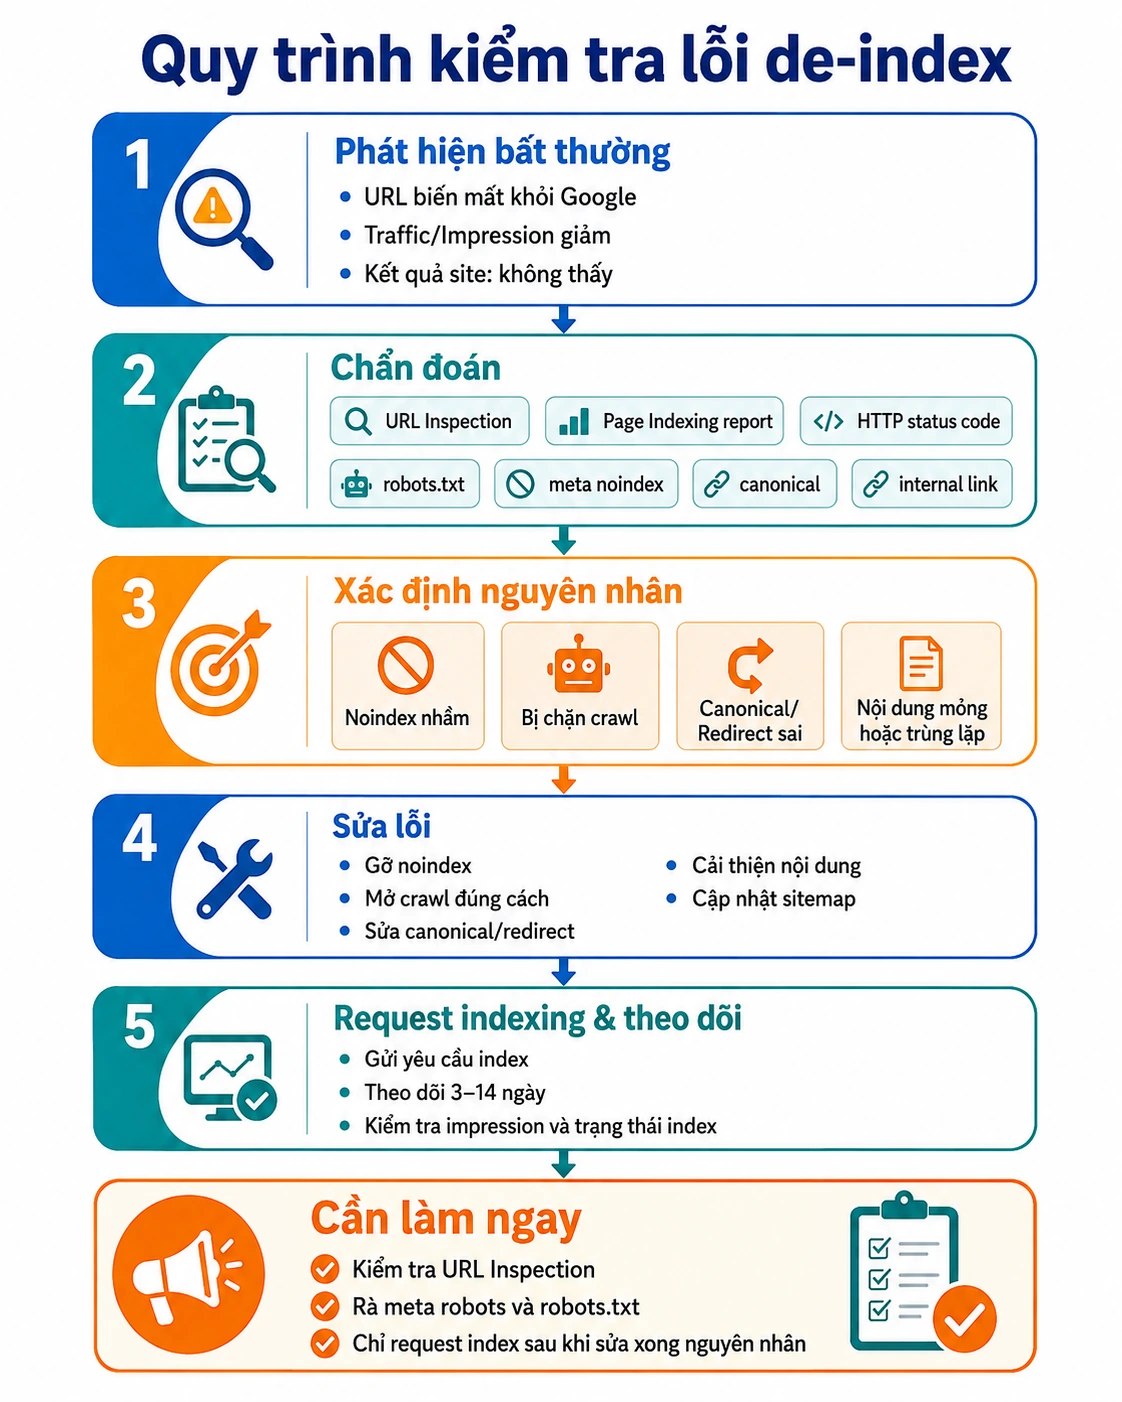
- Xác nhận owner URL và lịch sử: URL có thực sự từng index và còn cần index không?
- Kiểm tra HTTP/access: 200, redirects, 4xx/5xx, WAF/CDN và robots.
- Kiểm tra directives: meta robots, X-Robots-Tag và plugin/template.
- Kiểm tra canonical: declared/selected canonical, sitemap, internal links và redirects có cùng hướng?
- Kiểm tra render/mobile: nội dung chính có xuất hiện sau JavaScript và tương đương trên mobile?
- Đánh giá ownership/content: URL có trùng intent, quá mỏng, soft 404 hoặc đã có owner tốt hơn?
- Củng cố discovery: contextual internal link và sitemap cho preferred canonical URL.
- Request Indexing sau khi fix: chỉ cho URL ưu tiên; request crawl không bảo đảm index.
Các owner URL liên quan: lỗi noindex, robots.txt, duplicate/canonical, Sitemap XML và Internal Link.
Nguyên nhân thường gặp và fix ưu tiên
| Nguyên nhân | Evidence | Fix |
|---|---|---|
| Noindex nhầm | Meta/header + Inspection | Gỡ directive và QA template. |
| Robots chặn | robots.txt + logs | Mở crawl khi URL cần xử lý/index. |
| Canonical/duplicate | Selected canonical + similarity | Phân vai URL và đồng bộ signals. |
| Redirect/404/410 | Status/chain | Giữ lifecycle đúng; không redirect mọi URL về home. |
| Rendering | Raw/rendered diff | Sửa JS/API/resource access. |
| Orphan/weak discovery | Không có inlink, depth cao | Contextual internal links từ hub liên quan. |
| Server/CDN/WAF | 5xx, timeout, bot block | Sửa availability/rate limit/firewall. |
| Manual/security | GSC reports | Ưu tiên incident remediation. |
Thời gian phục hồi index: không có mốc cố định
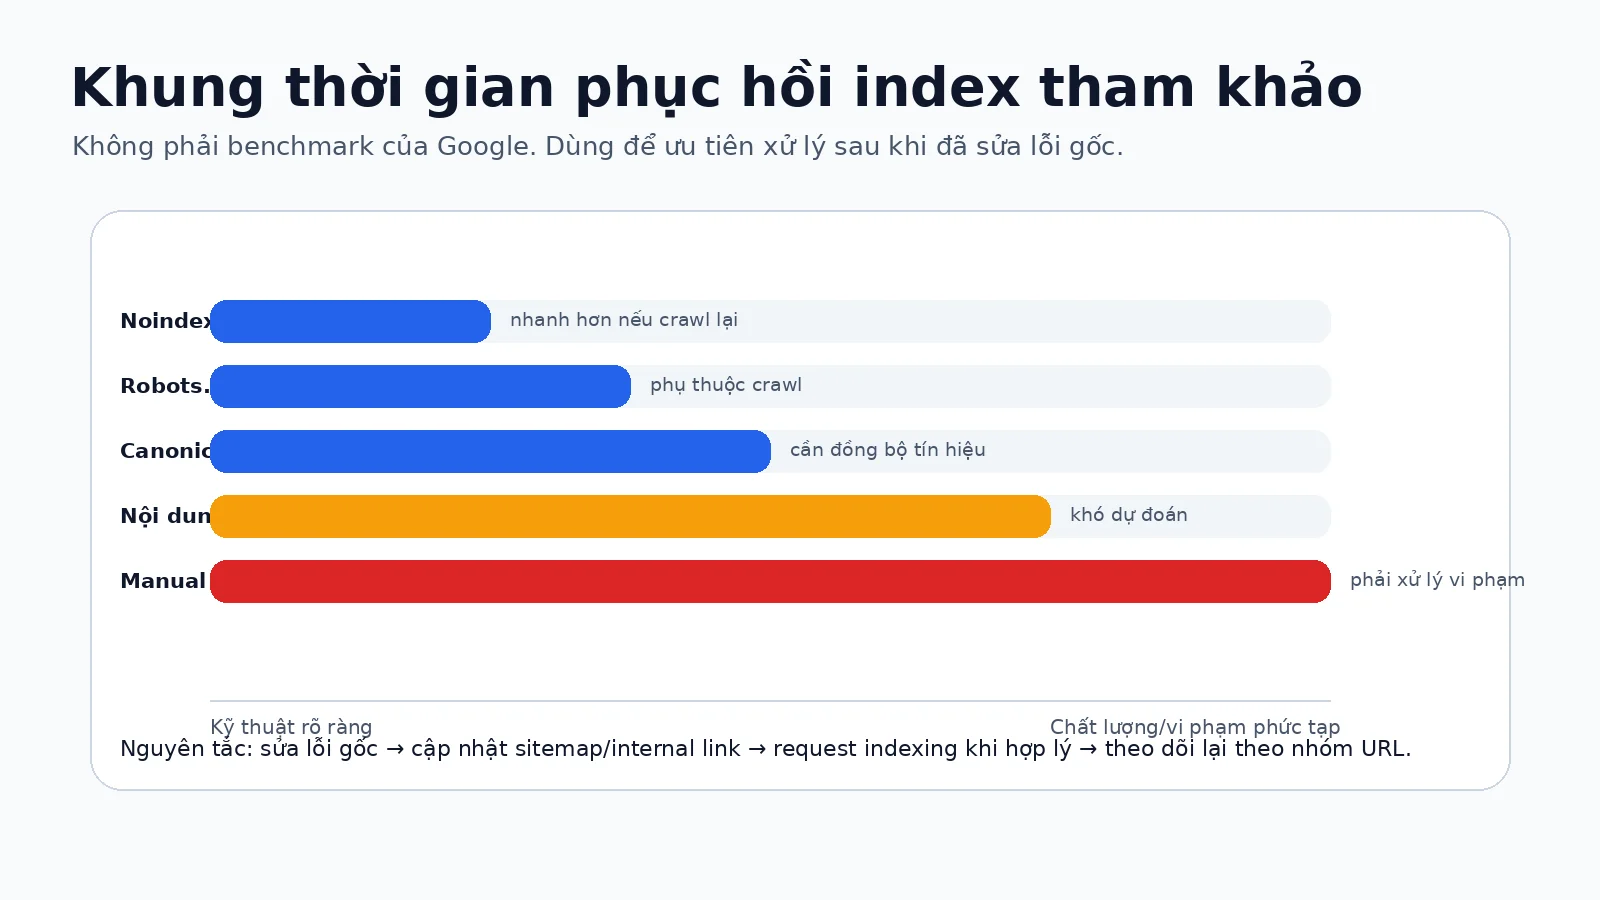
Google không cam kết thời gian index lại. Sau khi sửa, Google cần recrawl và xử lý tín hiệu. Noindex nhầm có thể dễ sửa về mặt kỹ thuật hơn duplicate/content ownership, nhưng không có con số ngày cố định có thể bảo đảm.
Checklist WordPress sau redesign hoặc đổi plugin SEO
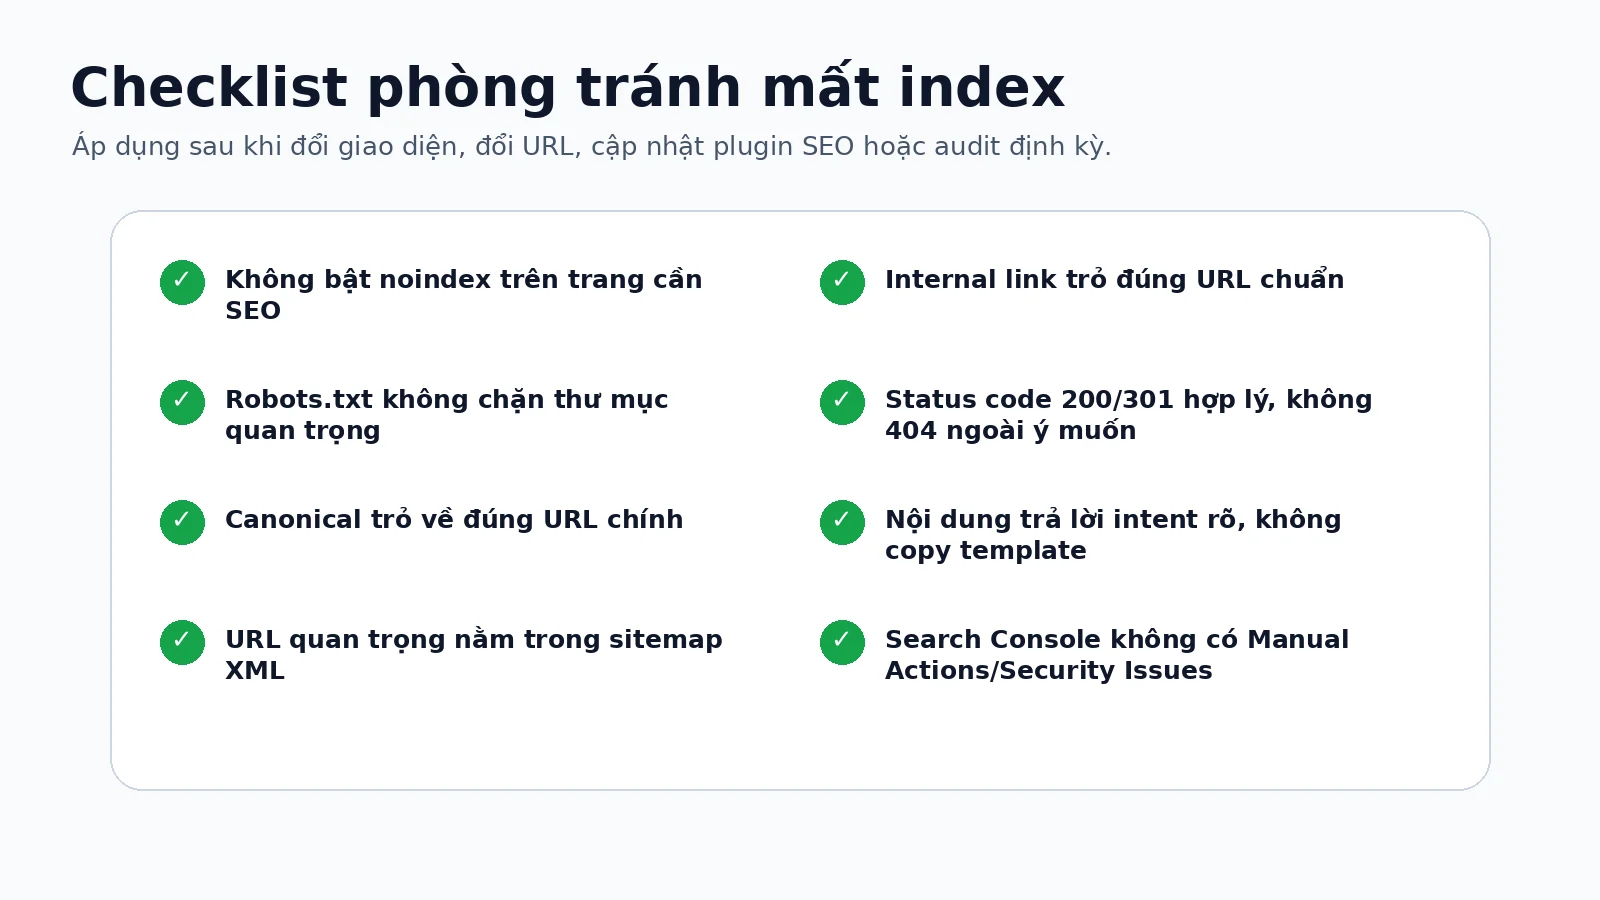
- Settings → Reading không bật chặn search engines ngoài ý muốn.
- Post type/taxonomy/URL quan trọng không bị noindex bởi plugin.
- Theme không chèn robots/canonical sai.
- Header server không có X-Robots-Tag ngoài ý muốn.
- robots.txt không Disallow quá rộng.
- Sitemap chỉ chứa preferred canonical indexable 200 URLs.
- Redirect map, menu và contextual internal links trỏ URL mới đúng.
- Mobile render có đủ nội dung chính.
FAQ
Request Indexing liên tục có giúp nhanh hơn không?
Không. Chỉ request sau khi thay đổi đã live và technical/content ownership đã được xử lý.
Website mất index sau redesign nên kiểm tra gì trước?
Robots, noindex, canonical, status và rendered content theo template. Nếu nhiều URL lỗi cùng lúc, audit template trước từng URL.
URL nào không nên index?
Ví dụ thank-you, login, cart/checkout, internal search, staging hoặc duplicate/facet không có search value. Dữ liệu riêng tư phải bảo vệ bằng authentication, không chỉ noindex/robots.
Kết luận
De-indexed là chẩn đoán cần lịch sử, không phải nhãn cho mọi URL vắng mặt trên Google. Hãy xác minh lịch sử index, kiểm tra access/directives/canonical/rendering, rồi mới đánh giá ownership và content. Với vấn đề diện rộng, bắt đầu từ Technical SEO và Content Audit.
Nguồn tham khảo
- How Google Search Works
- Page indexing report
- Block indexing with noindex
- Remove information from Search
- Canonicalization troubleshooting
- Ask Google to recrawl

Đoàn Trình Dục là Giảng viên Khoa Công nghệ Thông tin tại Đại học Công nghệ Sài Gòn (STU), với hơn 10 năm kinh nghiệm thực chiến trong các lĩnh vực Mạng máy tính, Marketing Online, SEO và Bảo mật hệ thống.
Với nền tảng sư phạm và kinh nghiệm tư vấn cho nhiều doanh nghiệp, thầy chuyên sâu vào việc xây dựng các giải pháp kỹ thuật số toàn diện và hiệu quả.